Experiências criando um robô de atendimento em um ambiente complexo: multi-agente com LangGraph
Na empresa onde trabalho, boa parte das compras chega por mensagem, e cliente compra do jeito que dá. Manda foto de uma lista escrita à mão, áudio no meio do expediente, PDF de um orçamento antigo, planilha exportada do sistema dele. Durante muito tempo, quem recebia isso no WhatsApp era uma pessoa do atendimento, que lia a mensagem, procurava produto por produto na loja virtual, montava o carrinho e devolvia para o cliente confirmar. Quem já fez isso sabe o quanto é repetitivo, uma lista de trinta itens vira trinta buscas, e no pico de mensagens a fila só cresce.
A gente construiu um agente para fazer esse trabalho conversando. O cliente fala o que precisa, por texto, áudio, foto ou documento, e o pedido aparece montado no carrinho dele, pronto para revisar e fechar.
Neste post quero contar como foi montar a arquitetura multi-agente que roda por baixo, com LangGraph, por que a gente saiu de um agente único para um supervisor com especialistas, como a gente escolhe o modelo, o que aconteceu com os atendentes e o que até hoje dá trabalho. Os trechos de código são simplificados, só troquei os nomes que identificariam a empresa e o serviço.
Do notebook ao primeiro agente
Começou como laboratório. Um repositório com Jupyter configurado para testar hipóteses soltas, um SDK interno para fazer login, buscar produto, montar carrinho e fechar pedido via API, a LangChain para configurar o agente e o LangGraph para orquestrar.
O primeiro aprendizado nem foi de IA. Tentar fazer uma compra de ponta a ponta chamando as APIs da loja por código mostrou buraco no produto e rota que precisava existir e não existia, e antes de ensinar um modelo a comprar a gente teve que garantir que dava para comprar sem tela.
Pouco depois o laboratório virou projeto, com integração ao WhatsApp, leitura de texto, áudio, imagem e PDF, e um agente só, com todas as ferramentas na mão, buscar produto, adicionar no carrinho, limpar o carrinho, consultar pedido, ver limite de crédito, trocar de empresa, tudo num prompt e num conjunto de tools.
Para demo funcionava muito bem. O problema apareceu quando a conversa deixou de ser a da demo.
Por que um agente só não deu conta
Um agente com todas as tools tem um prompt que precisa explicar todas as regras de todas as tools ao mesmo tempo. A regra de quantidade mínima do produto convive com a regra de como mostrar o limite de crédito, que convive com a regra de como trocar de empresa, e cada regra nova deixa as outras um pouco mais fracas. Tools parecidas também competem entre si, “adicionar produtos” e “atualizar produtos no carrinho” são quase a mesma frase para o modelo, e quando ele escolhe a errada o cliente recebe 40 caixas a mais de papel em vez de trocar a quantidade para 40.
Investigar também ficou difícil. Quando uma resposta saía errada, a pergunta era sempre a mesma, o que o modelo entendeu dessa mensagem? Com um agente só, a resposta estava enterrada num histórico enorme, misturada com tudo.
Foi aí que a gente migrou para o padrão supervisor. Foi divertido e complexo, avançando devagar, mas a troca em produção saiu em poucas semanas.
Um supervisor que não faz nada
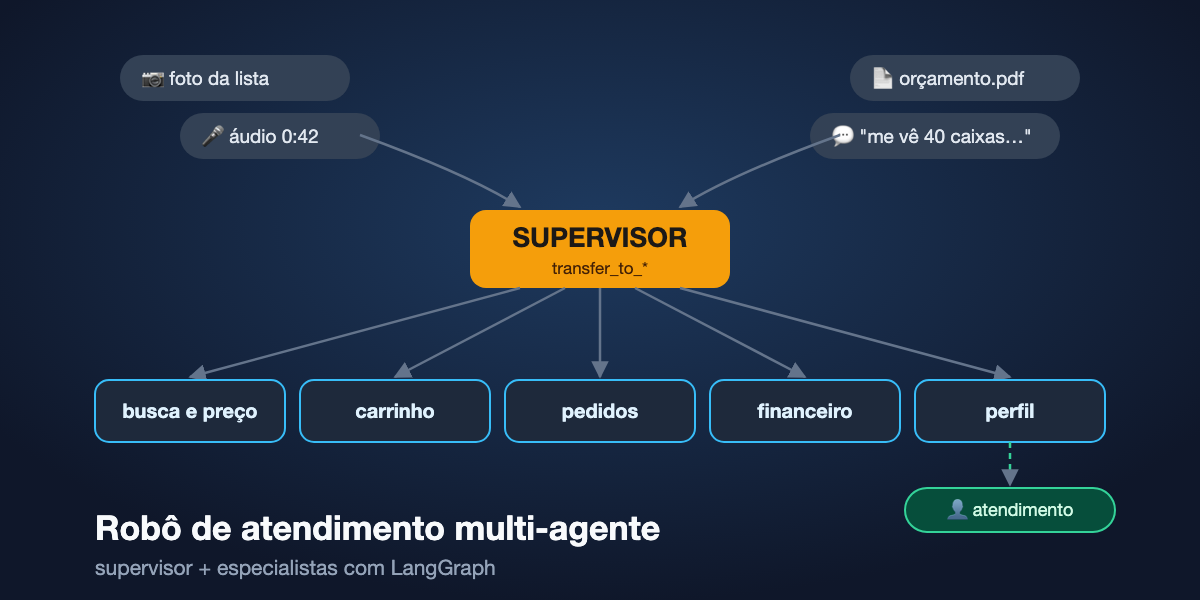
A ideia é simples de explicar. Existe um agente supervisor que não executa nenhuma ação de negócio, ele não busca produto, não mexe no carrinho e não consulta pedido. As únicas ferramentas que ele tem são de transferência, uma para cada especialista.
                 mensagem do cliente
                         |
                         v
                  +--------------+
                  |  SUPERVISOR  |   só tem transfer_to_*
                  +--------------+
                   /   |    |   \    \
                  v    v    v    v    v
            busca  carrinho pedidos financeiro boas-vindas
            e preço                            e perfil
                  \    |    |    /    /
                   v   v    v   v    v
                      tools -> APIs da loja
Hoje são cinco especialistas:
- Busca e preço: consulta produto, promoção, cupom e monta orçamento a partir de documento;
- Carrinho: adiciona, atualiza, limpa, mostra o carrinho e a previsão de entrega;
- Pedidos: lista os últimos pedidos, mostra detalhes e repete um pedido antigo;
- Financeiro: limite de crédito;
- Boas-vindas e perfil: apresentação, troca de empresa e transferência para o atendimento.
Cada especialista tem o próprio prompt, em Markdown, e só enxerga as tools do assunto dele. O prompt do carrinho não sabe nada de limite de crédito e o do financeiro não sabe o que é quantidade mínima, então quando uma regra muda a gente mexe num arquivo pequeno e sabe exatamente qual agente foi afetado.
No LangGraph, a transferência é uma tool que devolve um Command mandando o grafo para o nó do especialista:
@tool(f"transfer_to_{agent_name}", description=description)
def handoff_tool(
    instruction: Instruction,
    state: Annotated[MessagesState, InjectedState],
    tool_call_id: Annotated[str, InjectedToolCallId],
) -> Command:
    ...
    return Command(
        goto=agent_name,
        update={**state, "messages": handoff_messages, "instruction": instruction},
        graph=Command.PARENT,
    )
O detalhe que mais fez diferença está no argumento instruction. O supervisor não só escolhe para quem passar a conversa, ele tem que escrever um checklist curto, de até 300 caracteres, com o que o cliente pediu já interpretado, termos, quantidades, unidades e códigos. Para deixar concreto, a mensagem “me vê 40 caixa daquele papel A4 75g e tira as caneta” chega no especialista do carrinho já como uma instrução organizada, junto com os números de referência dos produtos que apareceram na busca anterior.
Na prática isso dividiu o trabalho em dois problemas menores. O supervisor resolve o que a pessoa quer, o especialista resolve como fazer isso com as tools dele, e quando algo sai errado o trace mostra em qual das duas etapas foi.
A volta também é controlada. Quando o especialista termina, só a última mensagem dele volta para o supervisor, e não todo o raciocínio intermediário, assim o histórico do supervisor fica enxuto e ele não começa a se confundir com detalhes de execução que não eram dele.
Por que não o supervisor pronto
O ecossistema do LangGraph tem um pacote de supervisor pronto, mas a gente acabou montando o grafo na mão, com StateGraph, porque precisava controlar três coisas do nosso jeito.
Resposta direta. Algumas tools já devolvem a mensagem final pronta, como a lista de produtos encontrados, o resumo do carrinho depois de processar um documento ou a lista de pedidos. Se o especialista reescreve esse conteúdo, ele resume, muda a ordem e às vezes até “melhora” um preço. Essas tools marcam return_direct, e uma aresta condicional no grafo manda direto para o fim, sem o modelo tocar na resposta:
builder.add_conditional_edges(
    agent.name,
    should_return_direct_or_continue,
    {"return-direct": END, "continue": supervisor.name},
)
Paralelismo por agente. Quando o cliente pede papel e caneta, o especialista de busca dispara as duas buscas em paralelo e depois junta as duas listas numa mensagem só, ordenada. Só que paralelismo no lugar errado vira bagunça. O supervisor roda com parallel_tool_calls=False, porque duas transferências ao mesmo tempo não fazem sentido, o agente do carrinho também, porque adicionar e atualizar em paralelo no mesmo carrinho é pedir para dar errado, e o de pedidos também, porque três tools dele respondem direto ao cliente e em paralelo ele receberia duas respostas para uma pergunta só.
Rastreamento. Cada transferência, cada tool e cada resposta passa por um rastreador próprio, que grava os passos da conversa no banco e mostra num painel quem passou para quem, com qual instrução, quanto custou em tokens e o que cada tool devolveu. É esse painel que o time abre todo dia para entender as conversas.
Memória e o detalhe que quebra conversas antigas
O estado do grafo fica no Postgres, com o PostgresSaver do LangGraph guardando o histórico de cada conversa e o PostgresStore guardando o que precisa sobreviver entre turnos, como o resultado da última busca, para que “coloca o 2 no carrinho” saiba qual é o produto 2.
Essa parte tem uma armadilha que não aparece no tutorial. O checkpoint serializa o estado inteiro, e se no estado aparece um tipo seu, um enum ou um modelo do Pydantic, o serializer precisa saber que pode reconstruir aquele tipo. A gente esbarrou nisso cedo, com um erro de serialização usando o store dentro de uma tool, e precisou ir até as issues do LangGraph para resolver.
Hoje existe uma lista explícita dos tipos permitidos, e o comentário em cima dela é o tipo de coisa que eu gostaria de ter lido antes:
# Entries are import paths persisted inside existing checkpoints — moving or
# renaming these symbols breaks already-stored conversation threads.
CHECKPOINT_ALLOWED_MSGPACK_MODULES = [
    ("app.agents.scaffolding", "Instruction"),
    ...
]
Ou seja, renomear uma classe, coisa que qualquer refactor faz sem pensar, quebra as conversas que já estão em andamento. Num sistema conversacional, o estado salvo também precisa ser tratado como contrato.
Restrição é tool desligada, não frase no prompt
Uma decisão que simplificou muita coisa foi tratar restrição como ausência de tool. O mesmo grafo atende o WhatsApp e chats dentro de aplicativos, e nem todo canal tem tudo, em alguns não existe transferência para o atendimento, e nem todo usuário pode trocar de empresa.
A primeira tentação é escrever no prompt “neste canal não ofereça transferência”. Funciona quase sempre, e o problema é justamente o quase. O que a gente faz é não ligar a tool no agente quando o canal não tem aquela capacidade, e o mesmo filtro serve para restrição por papel do usuário. Se a tool não está ligada, o modelo não tem como chamar, e também não tem como prometer o que não consegue fazer.
O contrário também vale. O supervisor ganhou uma tool específica para transferir a conversa quando percebe que o cliente está irritado, porque a gente via nas conversas cliente pedindo para falar com uma pessoa várias vezes antes de conseguir. O que é importante a gente transforma em tool, em vez de deixar como uma frase no prompt.
O que ainda dá trabalho
O prompt também é código. Os templates de cada agente, os trechos que mudam por canal e as descrições das tools de transferência estão versionados e passam por PR como o resto, e é ali que mora boa parte dos bugs. Uma frase ambígua no prompt do supervisor manda a conversa para o especialista errado do mesmo jeito que um if invertido.
Determinismo. Quantidade errada no carrinho continua sendo o erro mais caro, porque o cliente confia no que vê e fecha o pedido. Boa parte das melhorias dos últimos meses foi tirar decisão do modelo e colocar em código, a tool valida quantidade mínima, a busca devolve referências numeradas e o checklist do supervisor carrega os números em vez de nomes.
Troca de modelo. Cada modelo novo muda o comportamento. A troca mais recente obrigou a mudar a forma de chamar a API, porque a partir de certa versão a API antiga passou a recusar tools com raciocínio ligado, e quase todo nó do nosso grafo chama tool. Escolher qual modelo usar acabou virando um processo à parte, que eu conto na próxima seção.
Testes de código que agente escreveu. Boa parte do código hoje é escrita com ajuda de agentes de código, então a gente adotou mutation testing nesse projeto também, pelo mesmo motivo que contei no post sobre o Stryker, cobertura alta não diz se o teste protege alguma coisa.
Escolhendo o modelo: pagando em dobro
Escolher o modelo não é uma decisão que se toma uma vez. Sai modelo novo mais barato, o fornecedor anuncia que vai desligar o que você usa, o preço muda, e cada troca muda o comportamento do agente de um jeito que nenhum benchmark mostra. O benchmark diz como o modelo se sai na prova dos outros, e a gente precisava saber como ele se sai nas listas de compra dos nossos clientes.
Por isso montamos a comparação dentro de produção, com o modelo candidato rodando como desafiante. Cada documento que o cliente envia vai, como sempre, para o modelo atual, que é quem responde. Em paralelo, a mesma requisição é publicada numa fila separada, e um consumidor manda o documento para o candidato e guarda o resultado numa tabela de comparação. O cliente nunca vê a resposta do candidato, e ligar ou desligar o experimento é só incluir ou tirar a fila de uma configuração.
O que faz essa comparação valer alguma coisa é a referência. Comparar dois modelos entre si só diz que eles discordam, não qual dos dois está certo, então a gente usa o trabalho que os atendentes já fazem. Quando alguém confere a lista extraída de um documento e corrige um item, aquela correção vira a resposta certa. A comparação separa os documentos em três grupos, que nunca se misturam:
- Corrigidos por uma pessoa: o modelo atual errou nesses itens, então um candidato que acerta a correção é melhor de verdade, e é o único grupo que dá veredito;
- Aprovados sem mudança: alguém conferiu e estava certo, então o candidato precisa concordar com o modelo atual;
- Aprovados automaticamente: ninguém conferiu, então a concordância serve só como indicativo.
A comparação olha só o código do produto e a quantidade, que é o que importa no carrinho. A descrição que cada modelo transcreve varia demais para servir de critério.
O lado ruim é bem claro, durante o experimento cada documento é lido por dois modelos e o custo de IA dobra. Tivemos que aumentar o limite de gasto na conta do fornecedor e combinamos de desligar a comparação no fim do mês, ligando de novo só quando aparece um candidato que vale a pena. Para mim é um custo que se paga, porque a alternativa é trocar de modelo olhando a tabela de preço e descobrir a diferença nos carrinhos dos clientes.
E a diferença apareceu. O candidato mais recente era bem mais rápido e bem mais barato, mas encontrava menos itens nos documentos corrigidos e às vezes inventava item que não estava no documento. Inventar é pior do que deixar de encontrar, um item não encontrado aparece para o cliente como “não encontrei” e ele resolve, já um item inventado entra no carrinho com cara de certo.
Aí veio o segundo aprendizado, a escolha não é só do modelo, é do modelo junto com o esforço de raciocínio, e por tarefa. Subindo o esforço de raciocínio do candidato, ele passou a encontrar os mesmos itens que o modelo atual nos testes, e ainda bem mais rápido. Ler documento e conversar são tarefas diferentes, e não precisam usar o mesmo modelo nem o mesmo esforço.
Na conversa, a medição ainda está pela metade. Tempo de resposta é fácil de medir, qualidade não, porque não existe um atendente corrigindo cada resposta do chat como existe para cada lista extraída, e montar essa referência é o próximo passo.
No fim, o critério ficou simples. O custo de IA é pequeno perto do valor dos pedidos que passam pelo agente, então ele entra como restrição e não como objetivo. O que decide é qualidade primeiro e velocidade depois, se o candidato entrega a mesma qualidade, mais rápido e pelo mesmo custo ou menos, ele entra, e se não entrega, nenhum desconto na tabela compensa.
E os atendentes?
Toda vez que eu apresento esse projeto alguém faz a mesma pergunta, o agente vai substituir os atendentes? A resposta curta é que não substituiu, e eu não acredito que vá substituir.
Eu mesmo já pensei nisso. Pouco antes do piloto começar, sugeri ao time guardar as conversas dos atendentes como base de dados, para um dia testar em paralelo como seria o agente fazendo a compra de ponta a ponta, sem ninguém do outro lado. A ideia está no backlog até hoje, e quanto mais conversa eu leio, menos acho que ela termina em substituição.
Para começar, o agente não fecha pedido sozinho, e isso foi uma decisão de desenho, não uma limitação. Ele busca, monta o carrinho, ajusta item por item, e quando o cliente diz que quer fechar, a conversa vai para uma pessoa ou para o checkout da loja. Esse foi o primeiro gatilho de transferência que a gente definiu, junto com o mais óbvio, o cliente pedir para falar com alguém a qualquer momento.
Depois vieram os outros, e cada um nasceu de uma conversa real:
- Erro que o agente não sabe tratar: três erros inesperados seguidos e a conversa vai para um atendente. Erro conhecido, como produto sem preço, não conta, porque o agente sabe explicar o que aconteceu;
- Carrinho parado: o cliente monta o carrinho e some, o agente manda um lembrete e, se mesmo assim ninguém responder, a conversa é transferida para um atendente dar sequência. Nos primeiros dias já teve cliente fechando pedido por causa disso, com uma pessoa;
- Cliente irritado: o supervisor ganhou uma tool só para perceber frustração e passar a conversa adiante, em vez de insistir. Teve cliente que, depois de algumas respostas erradas, chamou o robô de estagiário, e com razão;
- Busca que não encontra nada: em vez de pedir para o cliente tentar de novo com outras palavras, o agente avisa que o produto pode não estar disponível para ele e oferece o atendimento;
- Condição comercial: prazo, desconto e negociação o agente não decide, só encaminha.
Repara que nenhum desses casos se resolve com um modelo mais esperto. O cliente que quer negociar não quer uma resposta correta, quer alguém com autonomia para dizer sim, e o cliente irritado quer ser ouvido.
Por isso a gente parou de pensar na transferência como falha do agente e passou a tratar como parte do fluxo. A transferência leva duas mensagens, uma para o cliente, avisando que alguém vai assumir, e outra só para o atendente, com o motivo, a empresa identificada e um resumo do que aconteceu na conversa, o que foi pesquisado, qual carrinho foi montado, quantos produtos entraram e quantos não foram encontrados. Assim o atendente continua de onde o agente parou, em vez de começar do zero perguntando tudo de novo.
Até a palavra importou. No começo o agente oferecia “falar com um humano”, e a gente trocou para “vendedor” ou “atendimento”, porque é isso que o cliente procura, e porque “humano” dá a impressão de que do outro lado tem alguma coisa que não é.
E são os atendentes que mais ensinam o agente. Teve caso de o agente errar a quantidade no orçamento, a atendente corrigir e fechar o pedido mesmo assim, e no mesmo dia já ter um PR aberto para não repetir o erro. Boa parte das melhorias nasceu de alguém do atendimento mandando uma conversa e dizendo “olha isso aqui”, e o time até mantém uma lista de “clientes VIP”, gente que aparece toda semana com pedidos que nenhum prompt previu.
Ainda tem atrito no meio do caminho. Hoje, quando a conversa chega no atendente, ele refaz algumas verificações de cadastro que o agente já tinha feito, e isso é retrabalho que a gente quer tirar. Mas repara no sentido da melhoria, a ideia é deixar o trabalho do atendente mais fácil, e não fazer ele sumir.
O efeito mais concreto até agora não apareceu em quem saiu, apareceu em quem não precisou entrar. O volume de conversas cresceu, mais clientes passaram a comprar por mensagem, e a gente não precisou contratar novos atendentes para dar conta. Os mesmos atendentes passaram a atender mais, porque chegam nas conversas com o trabalho braçal já feito, o cliente identificado, o carrinho montado e o motivo da transferência escrito.
Dá para argumentar que não contratar é só substituição com outro nome, e eu vejo diferente. Ninguém perdeu o emprego para o agente, o que ele fez foi aumentar a capacidade de quem já estava lá. A pergunta que o projeto respondeu não foi quantas pessoas a gente consegue tirar, foi quanto a mais a mesma equipe consegue atender, e essa segunda resposta é muito melhor para todo mundo, inclusive para o cliente, que é atendido mais rápido.
O que eu acredito que muda é o trabalho, e não a existência dele. O agente fica com a parte repetitiva, ler uma lista de trinta itens, procurar um por um, conferir quantidade mínima, no meio de um pico de mensagens, e o atendente deixa de ser quem digita produto por produto e passa a ser quem resolve o que a máquina não consegue, com o carrinho já montado na frente dele.
Conclusão
Separar em supervisor e especialistas não deixou o sistema mais inteligente, deixou ele mais fácil de entender. Cada agente tem um prompt pequeno e um conjunto pequeno de tools, o supervisor só decide para quem passar e o que foi pedido, e quando uma conversa sai errada a gente sabe em qual etapa procurar.
Nem tudo foi tranquilo. Montar o grafo na mão deu mais trabalho do que usar o supervisor pronto, mas foi o que permitiu resposta direta, paralelismo por agente e rastreamento do nosso jeito. O estado salvo virou contrato sem ninguém avisar, e testar modelo em produção custa o dobro enquanto o experimento está ligado. Mesmo assim, foram essas escolhas que tiraram o sistema da demo.
E ele não saiu da demo para substituir ninguém. O agente ficou com a parte repetitiva, as pessoas ficaram com o que exige decisão, o atendimento cresceu sem precisar crescer a equipe, e uma das peças mais importantes acabou sendo das mais simples, a tool que passa a conversa para uma pessoa na hora certa.
Se eu fosse começar de novo, faria quase igual, começaria com um agente só e prestaria atenção no momento em que o prompt começa a ter regra demais. Quando chegar nesse ponto, separa por assunto, deixa um supervisor sem ferramentas de negócio e trata tudo que o modelo não pode fazer como uma tool que ele não tem.
PS: se alguém tiver uma boa forma de medir a qualidade das respostas de um chat sem depender de uma pessoa corrigindo cada conversa, me conta.
